
Сколько энергии потребляют нейросети: разбор по этапам
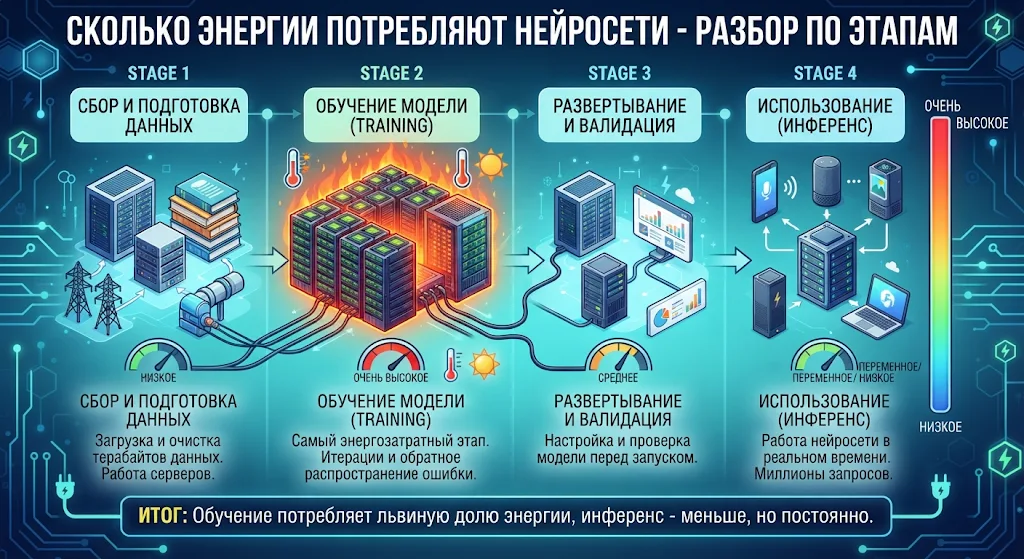
Энергопотребление нейросетей — тема, где легко уйти в крайности: от «один запрос сжигает лес» до «это как лампочка». Реальность посередине, и её полезно понимать хотя бы для того, чтобы не тиражировать мифы и осознанно выбирать инструменты.
Три этапа, и они очень разные
| Этап | Доля энергии | Особенность |
|---|---|---|
| Обучение | Единицы процентов от жизненного цикла | Разово, но очень много сразу |
| Инференс | Основная часть | Постоянно, растёт с числом запросов |
| Охлаждение и инфраструктура | Существенная добавка | Зависит от дата-центра |
Важный вывод: «дорогое обучение» — не главный источник. Больше энергии уходит на миллиарды ответов, которые люди запрашивают ежедневно.
Сколько это в бытовых единицах
Короткий запрос к текстовой модели сопоставим с несколькими секундами работы лампочки — порядок величин небольшой. Совсем другое дело генерация изображения или минуты видео: там расчёт идёт на десятки-сотни ватт-часов, и это уже заметно в масштабе тысяч генераций.
Почему цифры в статьях расходятся
- Одни считают только вычисления, другие — с охлаждением и сетью.
- Разные модели: маленькая и флагманская различаются в десятки раз.
- Разные дата-центры: эффективность охлаждения и источники энергии.
- Разная длина ответа: генерация токенов дороже чтения запроса.
Что действительно влияет
Длина контекста и объём ответа. Отправлять 50 страниц текста ради одного абзаца — это и дорого, и расточительно. Второй фактор — повторные запросы: одна и та же задача, решённая пять раз, умножает расход на пять.
Как расходовать разумно
- Формулируйте запрос точно: меньше итераций — меньше вычислений.
- Не тащите всю историю в каждый запрос, обрезайте лишнее.
- Для рутины берите младшую модель, флагман — для сложного.
- Генерируйте изображения по необходимости, а не «на выбор из десяти».
Что дальше
Развитие идёт в сторону эффективности: меньше параметров при том же качестве, кэширование ответов, оптимизация железа. Поэтому любые сегодняшние оценки устареют через год — но принцип «дороже там, где длиннее ответ» останется.
Промпты для расчётов
1. «Оцени, сколько энергии уйдёт на 1000 запросов с контекстом 2000 токенов». 2. «Сравни энергопотребление короткого ответа и генерации изображения». 3. «Как сократить расход, не теряя качество».
Почему «один запрос = столько-то литров воды» — плохая метрика
Такие оценки зависят от дата-центра, времени суток и способа охлаждения. Один и тот же запрос в разных регионах даст разный след. Полезнее смотреть на порядок величин и на собственное потребление: сколько запросов вы делаете и какой длины.
Что можно сделать на уровне компании
- Кэшировать повторяющиеся запросы: одни и те же ответы не нужно генерировать дважды.
- Выбирать младшие модели для рутинных операций.
- Ограничивать длину контекста и ответа.
- Не хранить историю «на всякий случай» — она увеличивает каждый следующий запрос.
Что важно помнить
Экономия вычислений почти всегда совпадает с экономией денег: те же приёмы снижают и счёт за API. Это удобный аргумент, который работает и для бюджета, и для отчётности по устойчивости.
Энергия нейросетей — это ещё и вопрос архитектуры: маленькая модель, обученная под задачу, часто тратит на ответ в десятки раз меньше, чем флагманская. Энергия нейросетей распределяется неравномерно: генерация изображений и видео на порядки дороже текстовых ответов.
Один запрос — это много?
Нет. Текстовый запрос по порядку величин сопоставим с работой бытовой лампы на несколько секунд.
Что энергозатратнее: обучение или работа?
Обучение — разовый и очень большой расход, но в масштабе миллионов пользователей основная энергия уходит на инференс.
Вредят ли нейросети экологии?
Как и любая вычислительная инфраструктура: вопрос в источниках энергии и эффективности дата-центров, а не в самой модели.
Можно ли снизить расход как пользователь?
Да: точные запросы, короткий контекст, младшие модели для рутины и отсутствие повторных генераций «на всякий случай».
Влияет ли длина ответа?
Да, заметно: генерация токенов дороже, чем обработка входного текста той же длины.