
Контекстное окно DeepSeek: сколько это и как использовать
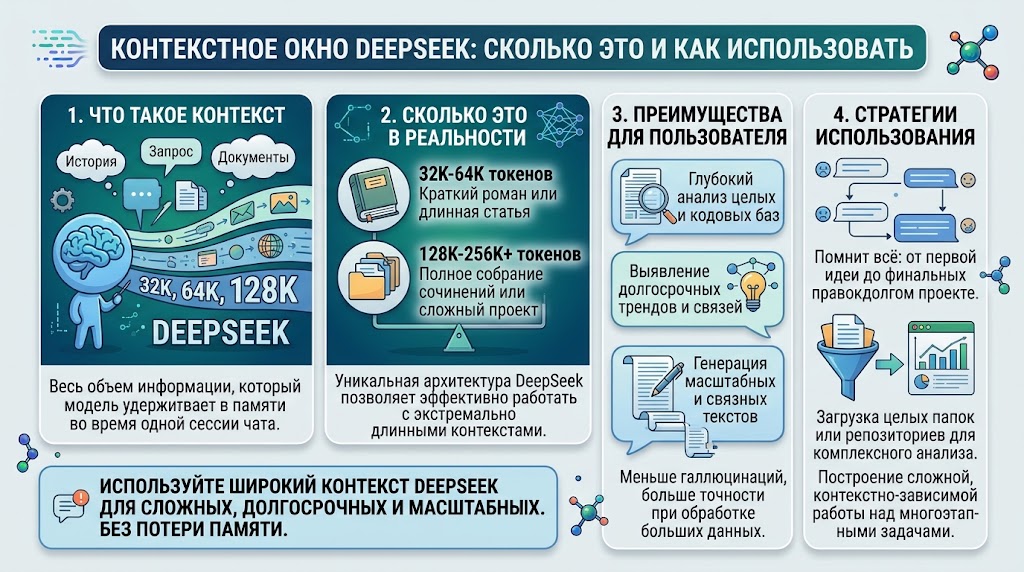
Контекстное окно DeepSeek — 1 млн токенов — главный технический аргумент в пользу сервиса, но понимают его неправильно: считают, что «можно загрузить всё и модель разберётся». На практике длинный контекст меняет не возможности, а стратегию работы: что отправлять целиком, что частями и как не платить за пересылку одного и того же документа десять раз.
Что такое контекстное окно DeepSeek простыми словами
Это объём текста, который модель держит «перед глазами» в одном запросе: ваш промпт, история диалога, загруженные файлы и её собственный ответ. Всё, что не поместилось, модель не видит — и не помнит.
У DeepSeek V4 окно 1 млн токенов для обеих моделей, V4.1-Flash и V4-Pro. Максимальный ответ — до 384 тыс. токенов, что тоже рекордно: большинство моделей ограничены 16–128 тысячами.
1 млн токенов — это сколько
| Что измеряем | Сколько помещается |
|---|---|
| Слов русского текста | примерно 700–800 тысяч |
| Страниц А4 плотного текста | около 1 500–2 000 |
| Книг среднего размера | 8–10 |
| Строк кода | порядка 60–90 тысяч |
| Файлов среднего проекта | 300–600 |
Цифры приблизительные: токен — это не слово и не буква, а единица разбиения, и для русского текста она «дороже», чем для английского. Поэтому кириллица занимает больше токенов на тот же смысл — это стоит учитывать при расчёте бюджета.
Что реально влезает в один запрос
- Книга целиком — с запасом на вопросы и ответы.
- Репозиторий среднего размера — со всеми модулями, тестами и конфигами.
- Годовой отчёт компании — включая таблицы и приложения.
- Архив переписки с клиентом — за несколько лет.
- 50–100 договоров — при разумной длине каждого.
Именно это отличает DeepSeek от моделей с окном 128–200 тысяч токенов: там всё перечисленное приходится резать на части, а значит — терять связи между фрагментами.
Почему длинный контекст не всегда помогает
Три ограничения, о которых не пишут в рекламе:
- Внимание рассеивается. На очень длинных входах модель хуже находит факт из середины документа, чем из начала или конца. Это известная особенность всех LLM, и DeepSeek не исключение.
- Стоимость растёт линейно. Каждый токен входа оплачивается, поэтому «отправить всё» — не стратегия, если задача решается главой из десяти страниц.
- Мусор мешает. Чем больше нерелевантного текста, тем выше шанс, что модель зацепится за неважную деталь.
Практический вывод: длинный контекст нужен не для «загрузить всё», а для «не резать по живому» — когда документ цельный и разрывать его вредно.
Кэш префикса: главный рычаг экономии
Если вы отправляете один и тот же блок (системный промпт, документ, историю), повторная отправка считается по цене кэш-попадания — $0,006 за миллион вместо $0,30. Разница в 50 раз.
| Сценарий | Без кэша | С кэшем |
|---|---|---|
| Документ 200 тыс. токенов, 10 вопросов | $0,60 | около $0,012 |
| Агентная сессия 50 шагов | $0,90 | $0,15 |
Условие одно: префикс должен совпадать байт в байт. Если вы меняете системный промпт в начале или порядок файлов, кэш не срабатывает. Отсюда рабочее правило: постоянные части контекста — в начале, переменные — в конце.
Стратегии работы с большими документами
Стратегия «карта → глава → вопрос». Сначала отправьте оглавление и попросите описать структуру. Затем — только нужные разделы. Это дороже по запросам, но точнее по ответам.
Стратегия «сводка по частям». Делите документ на главы, просите сводку по каждой, затем отправляйте сводки одним запросом. Теряются детали, сохраняется структура.
Стратегия «всё сразу». Оправдана, когда нужно найти связи между разными частями: противоречия в договоре, повторяющиеся условия, эволюция терминов. Здесь дробление вредит больше, чем помогает.
Ограничение на ответ: 384 тыс. токенов
Отдельная редкость линейки — длинный вывод. Модель может выдать ответ объёмом в несколько книг, что нетипично: у большинства конкурентов лимит 16–128 тысяч. Практически это значит, что можно попросить «перепиши весь регламент целиком», а не «покажи первые 500 слов».
Но есть нюанс: длинный ответ стоит дороже входа. При $1,20 за миллион исходящих токенов полная книга на выходе обойдётся примерно в $0,9 — не катастрофа, но и не бесплатно.
Сравнение с конкурентами
| Модель | Контекст | Макс. ответ |
|---|---|---|
| DeepSeek V4.1-Flash / V4-Pro | 1 млн | 384 тыс. |
| GPT-5.4 | 1 млн в API, ~196 тыс. в чате | 128 тыс. |
| Gemini 3.1 Pro | 1 млн | 64 тыс. |
| Claude Opus 4.6 | 200 тыс. | 64 тыс. |
Вывод: по контексту DeepSeek на уровне лидеров, по длине ответа — впереди. Разница в цене при этом кратная — см. DeepSeek API.
Как проверить свой сценарий
Возьмите реальный документ и посчитайте его объём: в чате это видно по реакции модели, в API — в поле usage ответа. Если вы укладываетесь в 30–40 % окна, запас есть; если подходите к 80 %, качество начнёт падать и лучше дробить задачу.
Пробовать длинный контекст удобнее в чате DeepSeek без регистрации — там же видно, как модель ведёт себя на больших файлах. Про загрузку документов — статья DeepSeek и файлы.
Контекстное окно DeepSeek и деньги: как считать бюджет
Формула простая: объём документа в токенах × цена входа + объём ответа × цена выхода. Документ на 300 тыс. токенов на модели flash вне пика — это $0,045 за один вопрос, а десять вопросов по нему с кэшем — меньше $0,05 в сумме.
Ошибка, которая дорого стоит: пересобирать промпт для каждого запроса. Если системная часть меняется, кэш не срабатывает, и вы платите полную цену каждый раз. Контекстное окно DeepSeek в 1 млн токенов провоцирует именно это — соблазн отправлять «всё и по-новому». Правило: постоянное — в начало и без изменений, переменное — в конец.
Большое контекстное окно DeepSeek не отменяет дисциплины: чем точнее вы отбираете материал, тем выше качество ответа и ниже счёт.
Какое контекстное окно у DeepSeek?
1 млн токенов у обеих актуальных моделей — V4.1-Flash и V4-Pro. Максимальная длина ответа — 384 тыс. токенов.
Сколько это в словах и страницах?
Примерно 700–800 тысяч слов русского текста, то есть 1 500–2 000 страниц А4 или 8–10 книг среднего размера.
Можно ли загрузить в DeepSeek всю книгу?
Технически да: книга помещается в контекст с запасом. Учитывайте авторские права и то, что на очень длинных текстах модель хуже находит факты из середины.
Почему повторный вопрос по тому же документу дешевле?
Работает кэш префикса: при совпадении начальной части запроса вход считается по $0,006 за миллион вместо $0,30 — в 50 раз дешевле.