
DeepSeek для программирования: код, отладка и ревью
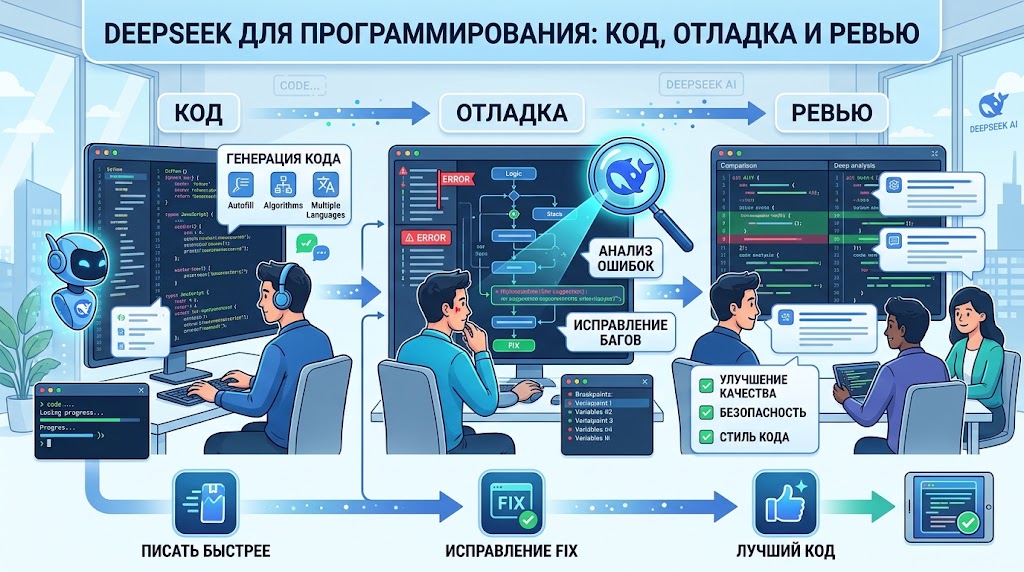
Дипсик для программирования — это не «ещё один автокомплит». Сильная сторона модели в другом: она держит в контексте весь проект целиком, находит причину бага по трассировке и не пытается переписать файл, который вы просили просто объяснить. За 2026 год по агентному кодингу DeepSeek вышел на уровень топовых закрытых моделей, и стоит при этом в разы дешевле.
Дипсик для программирования: где модель полезна
- Найти причину бага по логу, стеку и фрагменту кода — сильнейший сценарий.
- Разобрать чужой проект: что за архитектура, где точка входа, что делает модуль.
- Рефакторинг с сохранением поведения и написанием тестов до изменений.
- Миграции: смена библиотеки, версии фреймворка, переход на другой драйвер БД.
- SQL и оптимизация запросов — здесь модель заметно точнее среднего.
- Ревью перед мержем: список проблем с критичностью.
Чего ждать не стоит: генерации целого продукта «под ключ» с первого запроса и безошибочного знания API вашей внутренней библиотеки, если вы её не показали.
Насколько модель сильна в коде
Официальные цифры V4-Pro в режиме max выглядят внушительно, но их стоит читать с поправкой на бенчмарки.
| Бенчмарк | Результат V4-Pro (max) | Что он реально значит |
|---|---|---|
| LiveCodeBench | 93,5 % | решение олимпиадных задач по коду |
| Codeforces | 3206 | уровень сильного спортивного программиста |
| SWE Verified | 80,6 % | исправление реальных багов в открытых репозиториях |
| SWE Pro | 55,4 % | задачи повышенной сложности — здесь запас ещё есть |
Практический вывод для тех, кто использует дипсик для программирования: на задачах «найди и исправь» модель работает надёжно, на задачах «спроектируй систему с нуля» — помогает, но требует вашего контроля. SWE Pro в 55 % означает, что почти половину сложных задач она не закрывает сама.
1 млн токенов: как отдавать проект целиком
Контекст в 1 млн токенов — примерно 700–800 тысяч слов. Это позволяет не выбирать «самые важные файлы», а передавать репозиторий почти целиком. Работает так:
- Соберите дерево проекта:
find . -type f -name "*.py" | head -200. - Отправьте ключевые файлы и структуру, а не всё подряд: конфиги, модели, роуты, тесты.
- Попросите модель сначала описать архитектуру своими словами — это проверка, что она действительно прочитала код, а не угадала по названиям.
- Только после этого задавайте вопрос по существу.
Экономия: кэш префикса. Если вы отправляете тот же набор файлов повторно, вход считается по цене кэш-попадания — $0,006 за миллион вместо $0,30. Один и тот же контекст в десяти запросах обойдётся почти бесплатно.
Сценарии с готовыми промптами
Найти баг
Ты senior [язык]-разработчик. Ниже код и полная трассировка. Определи причину ошибки, укажи строку, объясни механизм возникновения. Предложи минимальную правку — не переписывай файл целиком. Если данных не хватает, скажи, что именно нужно показать. Код: […] Стек: […]
Отрефакторить
Отрефактори функцию, сохранив поведение и публичный интерфейс: убери дублирование, вынеси константы, добавь обработку None/пустых значений. Покажи unified diff и список изменений. Отдельно перечисли, что может сломаться у существующих вызовов.
Написать тесты
Напиши тесты для функции ниже на [pytest/jest]: покрытие всех ветвлений, граничные значения, два негативных сценария, один тест на конкурентный доступ. Не меняй саму функцию. Для каждого теста — комментарий, что он проверяет и почему этот кейс важен.
Разобрать чужой код
Объясни, что делает этот модуль: назначение, входные и выходные данные, побочные эффекты, зависимости. Отдельно — три места, которые выглядят опасными (гонки, N+1 запросы, необработанные исключения). Без предложений по рефакторингу, только разбор.
Миграция
Нужно перевести код с [старое] на [новое]. Составь пошаговый план: что меняется, в каком порядке, что тестировать после каждого шага. Покажи 2–3 характерных примера «до и после». Отметь места, где автоматическая замена даст неверный результат.
Ревью
Проверь код как ревьюер: архитектура, читаемость, обработка ошибок, безопасность, тесты. Формат — таблица «проблема — критичность (блокер/важно/мелочь) — как исправить». В конце три пункта, которые обязательно исправить до мержа, и три, которые можно отложить.
Автодополнение: FIM-режим
У дипсик для программирования есть FIM (fill-in-the-middle) — вставка кода в середину файла, то есть классический автокомплит. Работает только в non-thinking режиме, потому что рассуждения здесь только мешают. На практике это означает: для «дописать строку» включайте non-thinking, для «объяснить, почему падает» — high или max.
Подключение к редактору и агентам
| Инструмент | Как подключить |
|---|---|
| Claude Code | через Anthropic-совместимый эндпоинт api.deepseek.com/anthropic |
| OpenCode | официально поддерживает V4.1-Flash |
| Codex | через Responses API, есть готовый сценарий настройки |
| DeepSeek Harness | собственный агент DeepSeek: desktop-приложение или веб через npx |
| Свой скрипт | OpenAI SDK с base_url api.deepseek.com |
Если нужен именно агент, который сам читает репозиторий, правит файлы и запускает тесты, — см. DeepSeek Harness: что это и как установить. Если нужен просто API — ключ, цены и примеры запросов.
Где модель ошибается
- Устаревшие и выдуманные методы. Модель может уверенно вызвать функцию, которой нет. Проверяйте сигнатуры, а не доверяйте памяти.
- Версии библиотек. Если не указать версию, ответ будет про «среднюю» — и часто не про вашу.
- Скрытые побочные эффекты. Правка одной функции может ломать контракт, о котором модель не знает.
- Оптимизация «на глаз». Советы по производительности без профилирования — гипотезы, а не факты.
Правило простое: любой код от модели проходит через тесты и ревью человека. Не потому, что модель плоха, а потому что цена ошибки в коде выше, чем в тексте.
Безопасность
Дипсик для программирования опасен утечками: не отправляйте в чат ключи, токены, пароли и файлы .env — даже если очень хочется разобрать конфиг. Заменяйте значения на заглушки: модель поймёт структуру без реальных секретов. Для рабочих проектов под NDA используйте локальный запуск весов или модель с гарантией неиспользования данных.
Как вести сессию, чтобы модель не теряла контекст
Главная причина «глупых» ответов, когда дипсик для программирования не помогает, — не модель, а порядок работы. Рабочая схема из четырёх шагов:
- Сначала карта, потом задача. Отправьте структуру проекта и попросите описать архитектуру. Если описание неверное — модель не прочитала код, и дальше идти нет смысла.
- Одна задача — один диалог. Начали отлаживать оплату — не спрашивайте в том же чате про вёрстку. Смешанные контексты дают ответы «в среднем по проекту».
- Правки через diff. Просите unified diff и применяйте его сами или через git. Ответ «вот весь файл заново» почти всегда теряет куски, которые вы не заметили.
- Перезапуск сессии после 3–4 крупных правок. Контекст засоряется отказами и полумерами, модель начинает повторять неудачные решения. Новый диалог с актуальным кодом работает лучше, чем длинный с историей.
Отдельно про кэш: если вы каждый раз отправляете один и тот же системный промпт и набор файлов, вход считается по цене кэш-попадания — это в 50 раз дешевле. Поэтому «перезапустить сессию с теми же файлами» экономически почти бесплатно.
Пример: медленный эндпоинт
Типовая задача, на которой модель экономит час-два. Порядок запросов:
- «Вот view и модель. Где здесь может быть N+1 запрос? Покажи конкретные строки, не переписывай код.»
- «Предложи два варианта: select_related/prefetch_related и кэш. Для каждого — что изменится в количестве запросов и какие риски.»
- «Дай diff для выбранного варианта и тест, который поймает регресс: проверь число SQL-запросов через assertNumQueries.»
- «Какие места в проекте ещё обращаются к этой же модели без prefetch? Покажи список файлов.»
Четвёртый шаг — самый ценный: именно он находит те же грабли в других местах, куда вы бы не полезли руками. Формулируйте его как поиск, а не как исправление, иначе модель начнёт править файлы, которые вы не просили.
DeepSeek хорошо пишет код?
Да, на агентных бенчмарках V4-Pro набирает 93,5 % на LiveCodeBench и 80,6 % на SWE Verified — это уровень топовых моделей. При этом код всегда требует тестов и ревью: модель уверенно выдаёт несуществующие методы.
Какая модель DeepSeek лучше для программирования?
Для сложной отладки и математики — deepseek-v4-pro в режиме max. Для повседневной разработки и агентных задач выгоднее deepseek-flash: она почти не уступает, но дешевле в 4 раза и работает с изображениями.
Можно ли загрузить весь проект в DeepSeek?
Да, контекст 1 млн токенов вмещает крупный репозиторий. На практике стоит передавать структуру и ключевые файлы, а не всё подряд: так ответ точнее, а повторные запросы дешевле за счёт кэша префикса.
Есть ли у дипсик для программирования автодополнение, как в Copilot?
Есть FIM-режим (fill-in-the-middle) через API: он вставляет код в середину файла и работает только без режима мышления. В редакторах он подключается через плагины, поддерживающие OpenAI-совместимый эндпоинт.