
Модели DeepSeek: чем отличаются V4.1-Flash, V4-Pro, V3 и R1
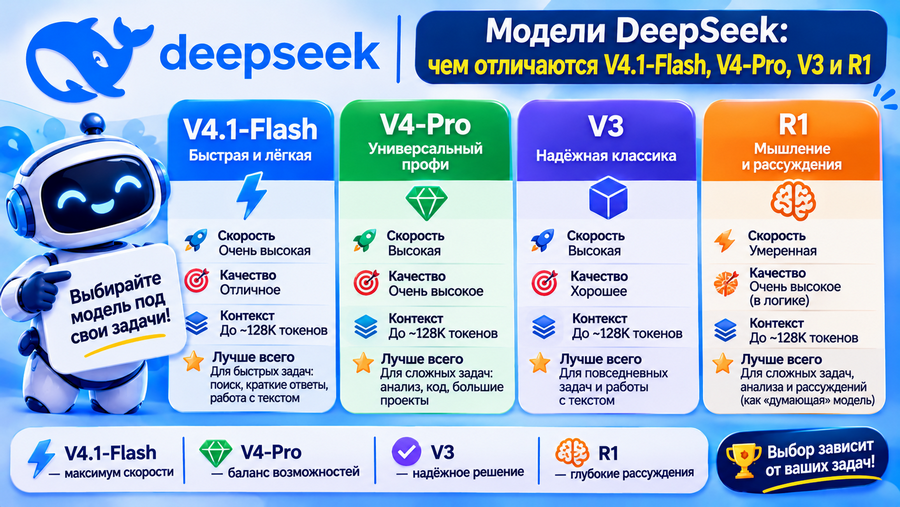
Модели DeepSeek за 2026 год менялись четыре раза, и в поиске до сих пор смешаны советы двухлетней давности: «включайте R1 для сложных задач», «берите V3 для текстов». Сейчас выбор проще, но не очевиднее: у DeepSeek две рабочие модели — V4.1-Flash и V4-Pro, и разница между ними не в «умнее/глупее», а в цене, скорости и работе с изображениями. Ниже — что есть в линейке, чем версии отличаются и что выбрать под конкретную задачу.
Короткий ответ: что выбрать
- Обычные задачи, тексты, чат, работа с фото и скриншотами — V4.1-Flash. Это модель по умолчанию в API и в большинстве клиентов.
- Сложная математика, олимпиадные задачи, отладка большого проекта, агентные сценарии на пределе — V4-Pro в режиме max.
- Локальный запуск на своём железе — V4-Flash или квантованные сборки V4.1-Flash; R1 и V3 уже не лучший выбор, но всё ещё встречаются в сторонних сервисах.
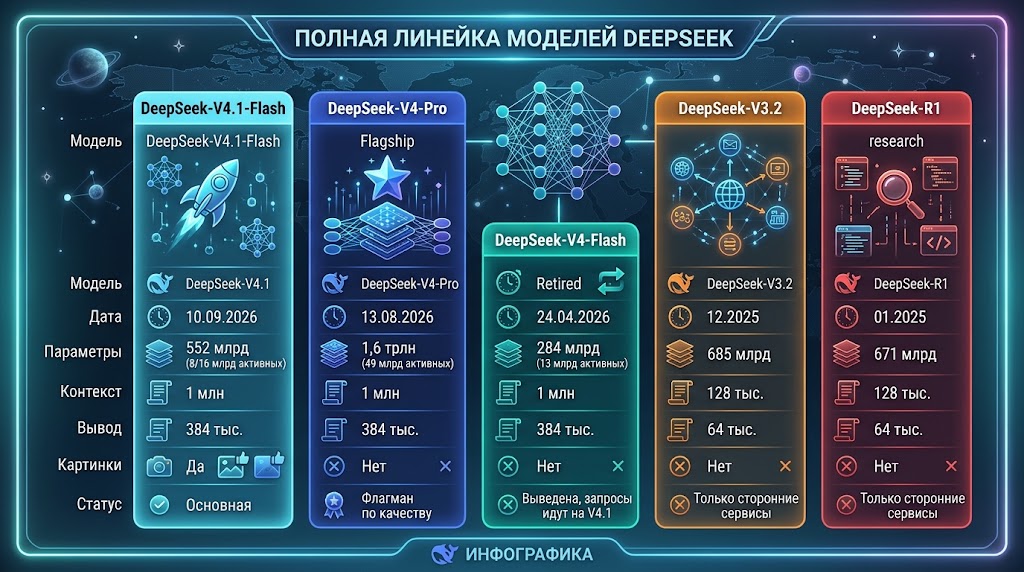
Все модели DeepSeek: полная линейка
Ниже — все модели DeepSeek, которые актуальны в ноябре 2026 года, включая снятые с производства.
| Модель | Дата | Параметры | Контекст | Вывод | Картинки | Статус |
|---|---|---|---|---|---|---|
| DeepSeek-V4.1-Flash | 10.09.2026 | 552 млрд (8/16 млрд активных) | 1 млн | 384 тыс. | Да | Основная |
| DeepSeek-V4-Pro | 13.08.2026 | 1,6 трлн (49 млрд активных) | 1 млн | 384 тыс. | Нет | Флагман по качеству |
| DeepSeek-V4-Flash | 24.04.2026 | 284 млрд (13 млрд активных) | 1 млн | 384 тыс. | Нет | Выведена, запросы идут на V4.1 |
| DeepSeek-V3.2 | 12.2025 | 685 млрд | 128 тыс. | 64 тыс. | Нет | Только сторонние сервисы |
| DeepSeek-R1 | 01.2025 | 671 млрд | 128 тыс. | 64 тыс. | Нет | Только сторонние сервисы |
DeepSeek-V4.1-Flash: почему именно она по умолчанию
Модель V4.1-Flash вышла 10 сентября 2026 года и стала первой в новой линейке моделей DeepSeek — Causal Encoder-Decoder. Смысл конструкции в асимметрии: на входе работает всего 8 млрд активных параметров, на выходе — 16 млрд, при общем объёме 552 млрд. Из-за этого модель отвечает быстрее предшественницы при более высоком качестве.
Что это даёт на практике:
- Понимает изображения. Единственная модель линейки с нативным vision: скриншоты, фото таблиц, схемы, рукописный текст.
- Дешевле флагмана примерно в 4 раза при сопоставимом или лучшем результате в агентных задачах.
- Меньше кэш. KV-кэш занимает в 4 раза меньше памяти HBM и в 8 раз меньше диска, чем у предыдущего поколения — для длинных диалогов это прямые деньги.
- 1 млн токенов контекста и до 384 тыс. токенов ответа.
Ограничение одно, но важное: это не «слабая» модель, а модель с другим балансом. На задачах, где нужна максимальная глубина — многошаговые доказательства, редкие баги в большом коде — V4-Pro в режиме max всё ещё сильнее.
DeepSeek-V4-Pro: когда он реально нужен
Флагман на 1,6 трлн параметров (49 млрд активных), GA-релиз 13 августа 2026 года. Сильные стороны подтверждены бенчмарками: LiveCodeBench 93,5 %, Codeforces 3206, GPQA Diamond 90,1 %, SWE Verified 80,6 %. В приложении и вебе он включается переключателем «Expert Mode».
Брать его стоит, если:
- задача требует длинной цепочки рассуждений и вы готовы ждать ответ дольше;
- нужен разбор большого репозитория с поиском неочевидной причины падения;
- считаете математику, где ошибка в одном шаге ломает всё;
- выполняете агентный сценарий с десятками шагов, где важна надёжность.
Не стоит брать для переписывания текстов, перевода, простых вопросов и всего, что связано с изображениями: он их не понимает, а платите вы втрое-вчетверо больше.
Режимы мышления: low, high, max
Глубина рассуждений — это не версия модели, а параметр. У V4.1-Flash и V4-Pro одинаковый набор:
| Режим | Когда включать | Что происходит |
|---|---|---|
| non-thinking | перевод, редактура, извлечение данных, простые ответы | минимум задержки, нет цепочки рассуждений |
| low | повседневные задачи средней сложности | короткая цепочка, быстрый ответ |
| high | агентные сценарии, код, анализ документов | полноценные рассуждения, режим по умолчанию в API |
| max | математика, отладка, многошаговые планы | максимальный результат бенчмарков, максимальная цена и время |
Типичная ошибка новичка — держать max всегда. На «перепиши письмо» это добавляет 20–40 секунд ожидания и лишние токены без выигрыша в качестве.
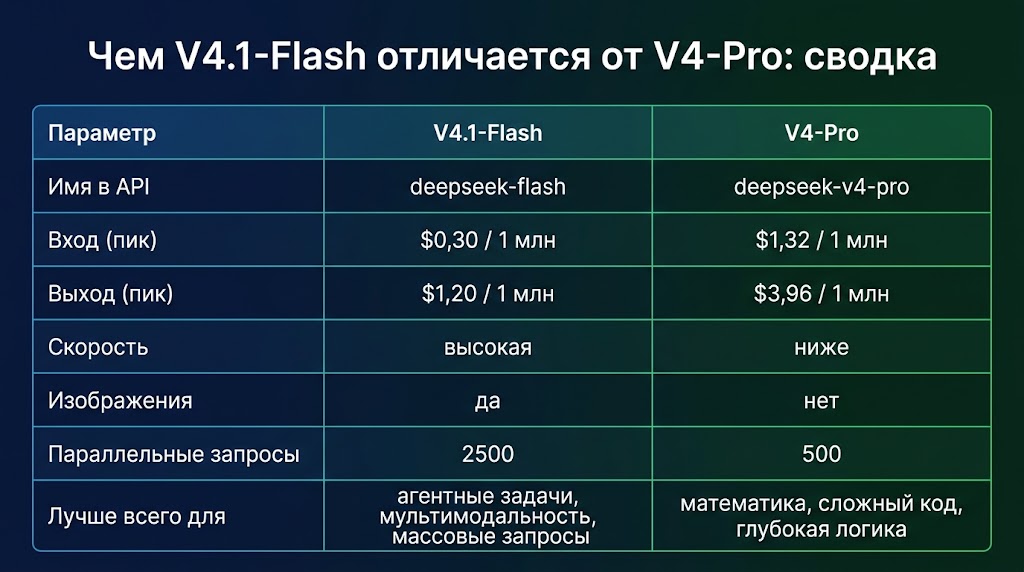
Чем V4.1-Flash отличается от V4-Pro: сводка
| Параметр | V4.1-Flash | V4-Pro |
|---|---|---|
| Имя в API | deepseek-flash |
deepseek-v4-pro |
| Вход, пик | $0,30 / 1 млн | $1,32 / 1 млн |
| Выход, пик | $1,20 / 1 млн | $3,96 / 1 млн |
| Скорость | высокая | ниже |
| Изображения | да | нет |
| Параллельные запросы | 2500 | 500 |
| Лучше всего в | агентные задачи, мультимодальность, массовые запросы | математика, сложный код, глубокая логика |
Что случилось с V3 и R1
Старые модели DeepSeek V3 и R1 советуют до сих пор — по инерции. Фактическое положение дел:
- Имена
deepseek-chatиdeepseek-reasonerофициально отключены с 24 июля 2026 года. - V4-Flash и V4-Flash-Vision-Exp сняты, их запросы автоматически обслуживаются V4.1-Flash по цене Flash.
- R1 осталась в истории как первая открытая reasoning-модель, но по всем метрикам проигрывает V4 — её имеет смысл вспоминать только в контексте локального запуска на слабом железе.
- В сторонних обёртках под названием «DeepSeek R1» часто скрывается обычная V4.1-Flash — проверяйте, что реально подключено.
Имена моделей и маршрутизация меняются
DeepSeek несколько раз за год перенаправляла старые имена на новые модели, чтобы не ломать интеграции: так было с V4-Flash, так было с V4-Pro. Если вы пишете код, не полагайтесь на память — сверяйтесь со страницей цен и документацией перед релизом, а в конфигах держите имя модели в одном месте, чтобы менять его за минуту.
Как проверить модель в конкретном сервисе
В большинстве русскоязычных обёрток модели DeepSeek выбираются вручную. Проверка простая: спросите, какое имя модели DeepSeek указано в настройках, и задайте задачу-маркер — например, попросите разобрать скриншот. Если сервис «не понимает» картинку, значит работает не V4.1-Flash, а текстовая модель.
Попробовать обе модели без установки можно в чате DeepSeek на русском: модель переключается в интерфейсе. Общее устройство нейросети разобрано в статье что такое DeepSeek, а цены и ключи — в материале про DeepSeek API.
Как переключать модель на практике
Способ переключения моделей DeepSeek зависит от того, чем вы пользуетесь, и это первое место, где люди теряют время.
- Веб-чат. Модель выбирается в выпадающем списке над полем ввода; в некоторых интерфейсах она называется «Выбор модели чат-бота», в других — «Экспертный режим». После переключения старый диалог продолжается, но отвечает уже другая модель — контекст она видит, историю не переписывает.
- API. Модель — это поле
modelв запросе. Один и тот же ключ работает с обеими моделями, отдельная регистрация не нужна, счёт общий. - Агенты и редакторы (Claude Code, OpenCode, Harness) держат имя модели в конфиге. Если модель перестала отвечать после обновления сервиса, первое, что нужно проверить, — актуальность имени.
Отдельно про режим «Экспертный»: в приложении и веб-чате DeepSeek он включает V4-Pro, а не «улучшает» Flash. Это именно переключение модели, поэтому ответы становятся медленнее и не работают с изображениями.
Что такое reasoning effort и как его задавать
Помимо выбора модели, у моделей DeepSeek V4 есть параметр усилия рассуждений. В API он передаётся как reasoning_effort со значениями low, high и max; при полном отключении модель работает в non-thinking режиме.
{
  "model": "deepseek-flash",
  "messages": [{"role": "user", "content": "..."}],
  "reasoning_effort": "max"
}
На практике модели DeepSeek хорошо отвечают и с низким усилием: low для переписывания и перевода, high для анализа документов и агентных шагов, max для математики, отладки и многошаговых планов. Разница в цене между low и max на длинной задаче доходит до трёх-четырёх раз — это тот рычаг, которым реально управляют бюджетом, а не сменой модели.
Какая версия моделей DeepSeek самая новая?
DeepSeek-V4.1-Flash-1017 — актуальная версия на ноябрь 2026 года, доступна в API под именем deepseek-flash. Флагманская V4-Pro (0813) остаётся сильнее в сложной математике и коде.
Что лучше: DeepSeek R1 или V3?
Ни то, ни другое — обе модели устарели. R1 (2025) и V3 (2024–2025) проигрывают V4.1-Flash по всем ключевым метрикам, а в официальном API их имена отключены с 24 июля 2026 года.
Чем V4-Pro отличается от V4.1-Flash?
V4-Pro крупнее (1,6 трлн против 552 млрд параметров), сильнее в математике и сложном коде, но не понимает изображения и стоит примерно в 4 раза дороже. V4.1-Flash быстрее, дешевле и работает с картинками.
Сколько режимов мышления у DeepSeek?
Три уровня усилия — low, high и max, плюс полностью отключённый режим non-thinking. В API по умолчанию включён thinking-режим уровня high.