
Как запустить DeepSeek локально: Ollama, LM Studio и требования
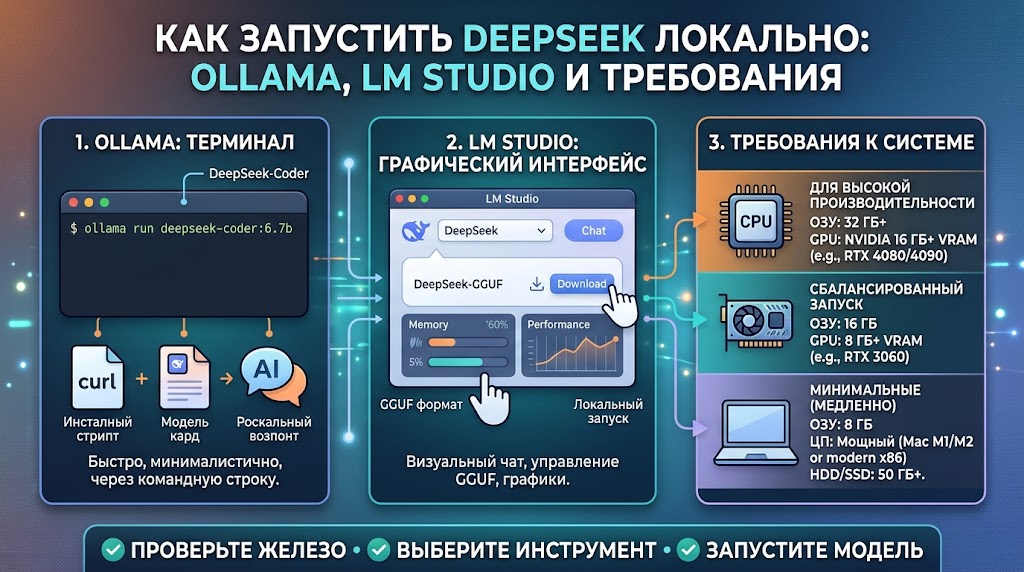
Запустить DeepSeek локально можно, но не тот DeepSeek, который в вебе. Полноценные V4.1-Flash и V4-Pro весят сотни гигабайт и требуют серверных ускорителей, а на домашней видеокарте реально работают дистилляты и квантованные версии.
Ниже — честная карта вариантов: что именно ставится, сколько нужно памяти и что теряется по качеству.
Запустить DeepSeek локально: что реально работает дома
- Дистилляты — модели 1.5B, 7B, 14B, 32B и 70B, обученные на ответах больших версий. Работают на одной видеокарте, понимают русский, но заметно слабее оригинала в сложных задачах.
- Квантованные версии — те же веса, сжатые до 4–5 бит. Теряют немного качества, но экономят память в 3–4 раза.
- Полные веса — сотни гигабайт оперативной памяти или несколько серверных GPU. Для дома и малого офиса это нереально, для компании с собственным железом — обсуждаемо.
Сколько нужно памяти
| Модель (квантование Q4) | Видеопамять | Что получится |
|---|---|---|
| 1.5B | 2–3 ГБ | Черновики, короткие ответы, почти без сложного кода |
| 7–8B | 5–6 ГБ | Бытовые задачи, простые скрипты, пересказ |
| 14B | 9–11 ГБ | Рабочий вариант для текстов и кода средней сложности |
| 32B | 20–24 ГБ | Близко к «маленькой» рабочей модели |
| 70B | 40–48 ГБ | Максимум качества среди домашних вариантов |
Если видеопамяти не хватает, часть слоёв уходит в оперативную память — скорость падает в разы. Поэтому 32B на 16 ГБ видеопамяти технически запустится, но отвечать будет медленнее, чем 14B.
Вариант 1: Ollama
Самый быстрый способ проверить идею. Ставится одной командой, модели скачиваются по имени, работает в фоне и отдаёт API на локальном порту — тот же формат, что у облачных сервисов. Подходит, если нужен офлайн-помощник без настройки.
- Установить Ollama с официального сайта.
- Скачать модель с нужным числом параметров и квантованием.
- Проверить ответ в терминале и подключить к своему приложению через локальный адрес.
Вариант 2: LM Studio
Вариант с графическим интерфейсом: поиск моделей, скачивание, настройка контекста и температуры — мышью. Удобно, когда нужно сравнить несколько моделей подряд или показать коллеге. Внутри тот же принцип: файл GGUF и ограничение по памяти.
Что теряется по сравнению с облаком
Локальная модель хуже держит длинный контекст, чаще путает факты и заметно слабее в многошаговых задачах: там, где облачная версия отвечает с первого раза, домашняя требует трёх попыток. Она не знает свежих событий, если у неё нет доступа к поиску, и не умеет работать с изображениями, если это не мультимодальный вариант. Зато данные не покидают машину и не зависят от лимитов.
Когда локальный запуск оправдан
- Приватность. Документы, медицинские данные, коммерческая тайна — то, что нельзя отправлять в облако.
- Офлайн. Работа без интернета и без VPN.
- Объём. Массовая обработка файлов, где оплата за токены выходит дороже своего железа.
- Эксперименты. Дообучение, свои промпты, сравнение моделей без ограничений API.
В остальных случаях облако дешевле и качественнее: разница в ответах на сложных задачах слишком велика, чтобы экономить на железе. Если после теста окажется, что запустить DeepSeek локально смысла нет, дешевле вернуться в облако, чем тратить недели на тюнинг железа.
Как запустить DeepSeek локально: пошаговый порядок
- Проверить видеокарту и объём памяти.
- Выбрать размер модели под эту память (см. таблицу).
- Поставить Ollama или LM Studio.
- Скачать квантование Q4 и прогнать 10 своих реальных задач.
- Сравнить с облачной версией: если разница терпима — оставить локально, иначе вернуться в облако.
Смотрите также
Можно ли запустить полный DeepSeek на домашнем компьютере?
Нет. Полные флагманские версии измеряются сотнями миллиардов параметров и требуют сотен гигабайт памяти. Дома реально работают только дистилляты и квантованные модели меньшего размера.
Сколько видеопамяти нужно для 14B?
Около 9–11 ГБ в квантовании Q4 при коротком контексте. Для длинных диалогов запас нужен больше, иначе часть слоёв уйдёт в оперативную память и скорость упадёт.
Локальная версия понимает русский?
Понимает, но качество зависит от размера: 7B отвечает с ошибками в падежах, 32B и 70B держат язык заметно лучше. Для русских текстов ниже 14B лучше не опускаться.
Нужен ли интернет после установки?
Нет, модель работает офлайн. Интернет нужен только для скачивания весов и обновлений. Это одно из главных преимуществ локального запуска.